
LV027-rtp头的timestamp
一、封装时的时间戳
1. 怎么处理的?
UINT clock_45K = 0; // UINT --》unsigned int
     ▼
clock_45K = venc_stream.pts * 45 / 1000; // 这里的vencStream.pts是从编码器获取的时间戳,单位为us,一般都是UINT64(unsigned long long)
     ▼
time_stamp = clock_45K << 1; // 相当于乘以2,PS封装的这里并没有看到需要左移
     ▼
buffer[pos++]	= (unsigned char)(time_stamp >> 24);      ///< 4字节RTP包时间戳,这里之前 pos= 4 --》 pos++=5
buffer[pos++]	= (unsigned char)(time_stamp >> 16);      ///<  pos= 5 --》 pos++=6
buffer[pos++]	= (unsigned char)(time_stamp >> 8);	     ///<  pos= 6 --》 pos++=7
buffer[pos++] = (unsigned char)(time_stamp & 0xff); ///< pos= 7 --》 pos++=81.1 为什么定义的是 UINT?
参考 RFC 3550: RTP: ARTP Fixed Header Fields:
    0                   1                   2                   3
    0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
   |V=2|P|X|  CC   |M|     PT      |       sequence number         |
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
   |                           timestamp                           |
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
   |           synchronization source (SSRC) identifier            |
   +=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+=+
   |            contributing source (CSRC) identifiers             |
   |                             ....                              |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+这里的 rtp 头中存放时间戳的字段为 timestamp,32-bits, 用于标识该 RTP 包所包含内容的采集(采样)时刻。对于 MPEG2、MPEG4、JPEG 和 H.264, 采用 1/90000 秒为单位; 对于 G.7xx 音频, 采用 1/8000 秒为单位。当一帧被分割成多个 RTP 包传输时, 这些包的 timestamp 应保持一致, 都是该帧的采样时刻。H.264 编码后数据的两个 AUD NAL unit 之间的单元所形成的 RTP 包 timestamp 应与前一个 AUDNAL unit 的 timestamp 一致。包含私有数据字段的 rtp 包 timestamp 需要根据私有字段的作用时刻准确填写。当该私有数据 rtp 包用于描述的编码码流包含视频流或与视频流相关的信息(如视频智能信息)时, 其 timestamp 以该视频流为基准, 单位亦相同(即以 1/90000 秒为单位); 否则根据实际应用情况确定。
它是一个 32 位的,所以前面要定义成 UINT 类型。那么这样就会有时间戳溢出的问题,
| 类型 | 位数 | 最大值 | 十进制表示 |
|---|---|---|---|
| unsigned int | 32 位 | 2³² - 1 | 4,294,967,295 |
| unsigned long long | 64 位 | 2⁶⁴ - 1 | 18,446,744,073,709,551,615 |
Tips:不同平台位数可能不同
unsigned int在某些嵌入式系统上可能是 16 位或 64 位- 建议使用
<climits>头文件中的UINT_MAX、ULONG_MAX等宏来获取确切的最大值
分别用来存储视频帧的时间戳的话,这里假设时间戳从 0 开始,视频是 25fps,间隔就是 40ms 一帧,来算一下最长可以存多久:
【微秒(μs)为单位】1ms = 1000μs,1s = 1000ms
| 存储类型 | 微秒数 | 秒 | 分钟 | 小时 | 天 |
|---|---|---|---|---|---|
| unsigned int | 4,294,967,295 | 4,295 | 71.6 分钟 | 1.19 | 0.05 |
| unsigned long long | 18,446,744,073,709,551,615 | 18,446,744,073,710 | 307,445,734,562 | 5,124,095,576 | 213,503,982 |
【毫秒(ms)为单位】1s = 1000ms
| 存储类型 | 毫秒数 | 秒 | 分钟 | 小时 | 天 |
|---|---|---|---|---|---|
| unsigned int | 4,294,967,295 | 4,294,967 | 71,583 | 1,193 小时 ≈ 49.7 天 | 49.7 |
| unsigned long long | 18,446,744,073,709,551,615 | 18,446,744,073,709,552 | 307,445,734,561,826 | 5,124,095,576,030 | 213503982335 |
1.2 乘以 90 了?
- 为什么要乘以 90?(先乘 45,又左移 1 位,相当于乘以 90)
时间戳单位:时间戳计算的单位不是秒之类的单位,而是由采样频率所代替的单位,这样做的目的就是 为了是时间戳单位更为精准。比如说一个音频的采样频率为 8000Hz,那么我们可以把时间戳单位设为 1 / 8000;MPEG-2/MPEG-4/H.264 等视频编码通常使用 27 MHz 的系统时钟(例如 PCR/DTS/PTS 的基准)。为了简化计算,协议将 27 MHz 除以 300 得到 90 kHz(即 27,000,000 ÷ 300 = 90,000 Hz)。90 kHz 意味着 每 1/90,000 秒(约 11.11 微秒)为一个时间单位。
Tips:90 kHz 能兼容常见的视频帧率(如 25 fps、30 fps)。例如:
- 25 fps 时,每帧占 3600 个时间戳单位(90,000 ÷ 25 = 3600)。
- 30 fps 时,每帧占 3000 个时间戳单位(90,000 ÷ 30 = 3000)。
这样时间戳是整数,避免了浮点数误差,便于硬件处理。
时间戳增量:相邻两个 RTP 包之间的时间差(以时间戳单位为基准)。
采样频率: 每秒钟抽取样本的次数,例如音频的采样率一般为 8000Hz。
(1)时间戳就是一个值,用来反映某个数据块的产生(采集)时间点的, 后采集的数据块的时间戳肯定是大于先采集的数据块的。有了这样一个时间戳,就可以标记数据块的先后顺序。
(2)在实时流传输中,数据采集后立刻传递到 RTP 模块进行发送,那么,其实,数据块的采集时间戳就直接作为 RTP 包的时间戳。
(3)如果用 RTP 来传输固定的文件,则这个时间戳 就是读文件的时间点,依次递增。这个不再我们当前的讨论范围内,暂时不考虑。
(4)时间戳的单位采用的是采样频率的倒数,例如采 样频率为 90000Hz 时,时间戳的单位为 1 / 90000 ,在 Jrtplib 库中,有设置时间戳单位的函数接口,而 ORTP 库中根据负载类型直接给定了时间戳的单位(音频负载 1/8000,视频负载 1 /90000)
(5)如果采样频率为 90000Hz,则由上面讨论可知,时间戳单位为 1/90000,我们就假设 1s 钟被划分了 90000 个时间块,那么,如果每秒发送 25 帧,那么,每一个帧的发送占多少个时间块呢?当然是 90000/25 = 3600。因此,我们根据定义“时间戳增量是发送第二个 RTP 包相距发送第一个 RTP 包时的时间间隔”,故时间戳增量应该为 3600。平时用的 25fps 的话,时间戳间隔是 40ms,乘以 90 就正好是 3600。
Tips:常见的都是先乘 45,然后左移,这样可能是因为乘法需要若干时钟周期(嵌入式/DSP 上可能很慢),但是移位和加法就几乎是 0 成本,硬件直接就支持,所以很多地方都是乘 45,然后左移,可以带来性能提升(尤其在嵌入式/硬件场景)。
2. 溢出问题
2.1 最大值
c语言中limits.h有两个宏定义可以帮我们获取当前系统中unsigned int和unsigned long long的最大值:
#include <stdio.h>
#include <limits.h>

int main(int argc, char *argv[]) {
    printf("unsigned int max: %u\n", UINT_MAX);
    printf("unsigned long long max: %llu\n", ULLONG_MAX);
    return 0;
}编译后运行的结果如下:
unsigned int max: 4294967295
unsigned long long max: 184467440737095516152.2 数据截断
接下来看一下一个unsigned long long类型的数据赋值给unsigned int类型会出现的情况:
#include <stdio.h>
#include <limits.h>

int main(int argc, char *argv[]) {
    unsigned int       a = 0;
    unsigned long long b = 0;

    printf("unsigned int max: %u\n", UINT_MAX);
    printf("unsigned long long max: %llu\n", ULLONG_MAX);
    printf("\n");

    /* 情况1:未截断 — b 的值在 unsigned int 范围内 */
    b = 12345678ULL;
    a = (unsigned int)b;
    printf("=== 未截断情况 ===\n");
    printf("a = %u(%x), b = %llu(%llx)\n", a, a, b, b);
    printf("a == b: %s\n\n", a == b ? "是" : "否");

    /* 情况2:截断 — b 的值超过 unsigned int 最大值 */
    b = 0x1234567887654321ULL;
    a = (unsigned int)b;
    printf("=== 截断情况 ===\n");
    printf("a = %u(%x), b = %llu(%llx)\n", a, a, b, b);
    printf("a == b: %s\n", a == b ? "是" : "否");
    printf("截断后丢失的高位值: %llu(%llx)\n", b >> 32, b >> 32);

    return 0;
}编译运行后输出信息如下:
unsigned int max: 4294967295
unsigned long long max: 18446744073709551615

=== 未截断情况 ===
a = 12345678(bc614e), b = 12345678(bc614e)
a == b: 是

=== 截断情况 ===
a = 2271560481(87654321), b = 1311768467139281697(1234567887654321)
a == b: 否
截断后丢失的高位值: 305419896(12345678)会发现,超过32位的数据高位被截断。从这里我们可以知道,编码器出来的64位时间戳在进行rtp包传输的时候,时间戳是有可能会出现截断的。
2.3 32位数据溢出
#include <stdio.h>
#include <limits.h>

int main(int argc, char *argv[]) {
    unsigned int a = 0;

    printf("unsigned int max: %u\n", UINT_MAX);
    printf("unsigned long long max: %llu\n", ULLONG_MAX);
    printf("\n");

    /* 情况1:未溢出 — a 的值在 unsigned int 范围内 */
    a = 0xffffffffULL;
    printf("=== 未溢出情况 ===\n");
    printf("a = %u(%x)\n", a, a);
    /* 情况2:溢出 — a 的值在 unsigned int 范围外 */
    printf("=== 溢出情况 ===\n");
    printf("a+1 = %u(%x)\n", a + 1, a + 1);
    printf("a+2 = %u(%x)\n", a + 2, a + 2);
    return 0;
}编译运行后,得到的输出信息如下:
unsigned int max: 4294967295
unsigned long long max: 18446744073709551615

=== 未溢出情况 ===
a = 4294967295(ffffffff)
=== 溢出情况 ===
a+1 = 0(0)
a+2 = 1(1)需要注意无法通过溢出的值准确反推原始值,因为:
(1)溢出操作是多对一映射。
(2)存在无限多个原始值会产生相同的溢出结果。
(3)信息在溢出过程中永久丢失。
2.4 计算过程中溢出
前面rtp封装时,在处理时间戳的时候是这样的:
UINT clock_45K = 0; // UINT --》unsigned int
clock_45K = venc_stream.pts * 45 / 1000;    // vencStream.pts是从编码器获取的时间戳,单位为us,一般都是UINT64(unsigned long long)
time_stamp = clock_45K << 1; // 相当于乘以2,PS封装的这里并没有看到需要左移venc_stream.pts一般是unsigned long long类型,它乘以45可能会发生溢出,然后除以1000,后赋值给一个unsigned int类型的clock_45K,这个时候可能会发生数据的截断,下面又有一个左移的操作,左移1位相当于乘以2,所以这里又可能会出现一次溢出。
3. 时间戳
3.1 unix 时间戳
Unix 时间戳(Unix Timestamp)的产生,源于计算机早期发展时对“时间基准”的需求。它的核心概念非常简单:从一个固定的时间点开始,计算经过的秒数。
从哪个固定时间点开始呢?
1969 年 8 月,贝尔实验室的程序员肯汤普逊利用妻儿离开一个月的机会,开始着手创造一个全新的革命性的操作系统,他使用 B 编译语言在老旧的 PDP-7 机器上开发出了 Unix 的一个版本。
随后,汤普逊和同事丹尼斯里奇改进了 B 语言,开发出了 C 语言,重写了 Unix,新版于 1971 年发布。
在 Unix 被发明出来之后,需要在 Unix 上表示时间,就需要想办法定义一个能表示一份数据在某个特定时间之前已经存在的、完整的、可验证的数据来表示时间。于是,Unix 时间戳被定义出来,即通过当前时间和一个 "纪元时间" 进行对比,其间相差的秒数作为时间戳。
为了让 Unix 时间戳表示时间这种方式用的尽可能久,最初就把 Unix 诞生的时间 1971-1-1 定义成 "纪元时间"。
除了开始时间是 1971-1-1 而不是 1970-1-1 外,最初的时间戳也不是每增加 1 秒时间戳就变动一次,而是每 1/60 秒都会改变一次时间戳。另外,Unix 是在 1971 年发明出来的,当时的计算机系统是 32 位,如果用 32 表示有整数,那么最大值是 2147483647(2^31-1)。
那么,简单做一个数学计算,如果用当时的时间戳计算方式来表示时间的话,Unix 时间戳最多可以使用 4294967296/(60*60*24)/60 = 828.5 天(一天有 60*60*24 秒,每 1/60 秒会占用一个时间戳)。
想象一下,设计出一个计算机系统,他的时间只能表示 828.5 天,是不是很难让人接受,但是最初的 Unix 确实是这样的。
后来,Unix 的开发者们也渐渐意识到这样不是长久之计,于是开始做出改变。
最开始,他们将每 1/60 秒改变一次时间戳修改成每 1 秒改变一次时间戳。这样时间戳可以表示的时间就又放大了 60 倍。这时候有 828.5*60/365 = 136 年。
这时候,一方面 136 年已经足够久了,纪元时间稍微向前调一下影响也不大。另外一方面为了方便记忆和使用。于是就把纪元时间从 1971-01-01 调整到 1970-01-01 了。
所以,Unix 时间戳的定义就是:从 1970 年 1 月 1 日 00:00:00 UTC 到现在所经过的秒数,不包括闰秒。
早期系统使用 32 位有符号整数(int32)来存储时间戳,最大值是 2,147,483,647。对应的时间是 2038 年 1 月 19 日 03:14:07 UTC。当下一秒到来时,整数会溢出,变成负数,系统时间会突然倒退回 1901 年,这就是著名的“2038 年问题”。
解决办法: 现在的主流系统和编程语言已经将时间戳升级为 64 位整数(int64),这样足以表示前后两千多亿年的时间,彻底解决了溢出问题。
3.2 jiffies
Tick:时间的“最小单位”,每次时钟中断的时间间隔称为一个 Tick,其长度为 1/HZ 秒。触发中断处理程序,更新系统时间、检查定时器、调度进程。HZ = 1000 时,每 1ms 发生一次 Tick,执行一次时间维护。一个 tick 代表多长时间,在内核的 CONFIG_HZ 中定义。比如 CONFIG_HZ = 200,则一个 jiffies 对应 5ms 时间。所以内核基于 jiffies 的定时器精度也是 5ms。
jiffies(64 位为 jiffies_64)是 Linux 内核维护的 全局计数器,以 HZ 为频率递增,记录系统启动后的时钟中断次数。
| HZ 值 | 时间分辨率 | 32 位溢出周期 |
|---|---|---|
| 100 | 10ms | 497 天 |
| 250 | 4ms | 198 天 |
| 1000 | 1ms | 49.7 天 |
| 300 | 3.33ms | 165 天 |
【回绕问题】:如果时钟频率是 1000hz,32 位的系统上。这个值 47.9 天就会溢出。如果溢出之前设定了定时器,溢出以后 jiffies 作为无符号数的值会小于超时时间的值,如果使用 current > timeout 就会导致错误的判断。操作系统提供了宏 time_after(current, timeout)可以避免这个问题:
#define time_after(current,timeout) ((long)(timeout) - (long)(current)< 0)只是把无符号输转化成有符号数就能解决这个问题吗?
假设 jiffies 是 1 个字节存储的,当前的时间是 13(1101),设定一个节拍以后超时,所以超时时间就是 14(1110).然后,过了 3 个节拍以后,当前时间变成了 current = 13 + 3 = 1101 + 0011 = 10000 = 0000 = 0,这个时候虽然超时了,但是(current = 0) < (timout=14),如果代码使用if(current > timeout)来判断是否超时就会判断错误。
那么如果把这两个数强制转化成有符号数,是不是就能正确判断了呢?计算机使用补码存储数字,负数原码转补码是+1 以后取反,所以 timeout = 1110 转成负数源码就是-1 再取反就是(1101 取反)1010 也就是-2,current 是 0,这个时候 current = 0 > timeout = -2 是成立的。
3.3 NTP 校时
网络时间协议NTP(Network Time Protocol)是TCP/IP协议族里面的一个应用层协议,用来使客户端和服务器之间进行时钟同步,提供高精准度的时间校正。NTP服务器从权威时钟源(例如原子钟、GPS)接收精确的协调世界时UTC,客户端再从服务器请求和接收时间。NTP基于UDP报文进行传输,使用的UDP端口号为123。
出于诸多原因,精确的时间对于网络至关重要,比如:
- 网络管理:从不同网络设备采集来的日志信息进行分析时,需要以时间作为参照依据。如果不同设备上的系统时间不一致,会因先后顺序等问题给故障定位带来障碍。
- 计费系统:计费业务对于时间尤其敏感,要求所有设备的时间保持一致,否则会引起计费不准确,导致用户质疑、投诉等。
- 协同处理:多个系统协同处理同一个复杂事件,为保证正确的执行顺序,多个系统必须参考同一时钟。
- 系统时间:某些应用或服务需要准确的时间来标记用户登录、交易等操作信息,确保可追溯记录。
因此有一个统一的标准时间对于网络而言意义重大。NTP就是用来使网络中的各个主机时钟同步的一种协议,他把主机的时钟同步到协调世界时UTC,其精度在LAN网络内可达1毫秒内,在WAN网络上可以达到几十毫秒内。
NTP最典型的授时方式是Client/Server方式,如下图所示:
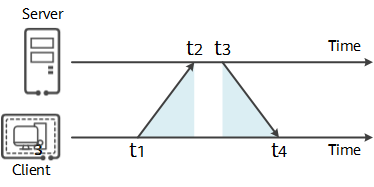
(1)客户端首先向服务端发送一个NTP请求报文,其中包含了该报文离开客户端的时间戳t1;
(2)NTP请求报文到达NTP服务器,此时NTP服务器的时刻为t2。当服务端接收到该报文时,NTP服务器处理之后,于t3时刻发出NTP应答报文。该应答报文中携带报文离开NTP客户端时的时间戳t1、到达NTP服务器时的时间戳t2、离开NTP服务器时的时间戳t3;
(3)客户端在接收到响应报文时,记录报文返回的时间戳t4。
客户端用上述4个时间戳参数就能够计算出2个关键参数:
NTP报文从客户端到服务器的往返延迟delay:
客户端与服务端之间的时间差offset:
从这个方程组中解出offset为:
NTP客户端根据计算得到的offset来调整自己的时钟,实现与NTP服务器的时钟同步。
3.4 linux 时间戳与本地时间
3.4.1 GMT、UTC与CTS
- UTC(世界标准时间)
协调世界时,又称世界标准时间或世界协调时间,简称UTC(从英文“Coordinated Universal Time”/法文“Temps Universel Coordonné”而来),是最主要的世界时间标准,其以原子时秒长为基础,在时刻上尽量接近于格林尼治标准时间。
- GMT(格林尼治平时)
格林尼治平时(又称格林尼治平均时间或格林尼治标准时间,旧译格林威治标准时间;英语:Greenwich Mean Time,GMT)是指位于英国伦敦郊区的皇家格林尼治天文台的标准时间,因为本初子午线被定义在通过那里的经线。
理论上来说,格林尼治标准时间的正午是指当太阳横穿格林尼治子午线时(也就是在格林尼治上空最高点时)的时间。由于地球在它的椭圆轨道里的运动速度不均匀,这个时刻可能与实际的太阳时有误差,最大误差达16分钟。
由于地球每天的自转是有些不规则的,而且正在缓慢减速,因此格林尼治时间已经不再被作为标准时间使用。现在的标准时间,是由原子钟报时的协调世界时(UTC)。
- CST(北京时间)
北京时间,China Standard Time,中国标准时间。在时区划分上,属东八区,比协调世界时早8小时,记为UTC+8。不过这个CST这个缩写比较纠结的是它可以同时代表另外三个不同的时间:
(1)美国中央标准时间:Central Standard Time (USA) UT-6:00
(2)Central Standard Time (Australia) UT+9:30 China Standard Time UT+8:00
(3)古巴标准时间:Cuba Standard Time UT-4:00
3.4.2 本地时间
c 语言中 time 函数拿到的时间戳为 UTC时间戳,怎么转为本地时间或者UTC时间?
| 函数 | 作用 | 时区处理 |
|---|---|---|
localtime() | UTC时间戳 → 本地时间结构 | 考虑系统时区 |
gmtime() | UTC时间戳 → UTC时间结构 | 不考虑时区(始终为UTC) |
mktime() | 本地时间结构 → UTC时间戳 | 考虑系统时区 |
timegm() | UTC时间结构 → UTC时间戳 | 不考虑时区 |
二、解封装
buffer 中存放是是一个完整的 rtp 包,包括 rtp 头,可以用下面的方式解出时间戳:
    time_stamp_tmp = (buffer[4] << 24)
                      | (buffer[5] << 16)
                      | (buffer[6] << 8)
                      | (buffer[7]);
        ▼
time_stamp = time_stamp_tmp / 90参考资料:
Linux 内核中的 jiffies 及其作用介绍及 jiffies 等相关函数详解 - 专注 it - 博客园
为什么计算机起始时间是 1970 年 1 月 1 日?-腾讯云开发者社区-腾讯云
time_after 方法对 jiffies 回绕问题的解决 - 知乎